Como Economizar Tokens com o JEV: Guia Prático de Roteamento para LLMs
Aprenda como o Jev reduz em até 80% o custo de tokens em aplicações com Claude, Codex e OpenAI através de decisões estruturadas e baratas antes da LLM.
Fernando Bolzan
// SaaS & AI Architect
O Problema Invisível: Gastando LLM Cara Para Decidir Coisas Simples
A grande maioria dos desenvolvedores e builders que constroem agentes ou SaaS com inteligência artificial comete o mesmo erro silencioso de arquitetura: tratar a LLM como a ferramenta padrão para qualquer tarefa do sistema.
Cada mensagem que chega do usuário, dúvida básica de FAQ, consulta de status ou triagem de suporte dispara imediatamente uma chamada para modelos de última geração, como Claude 3.7 / Claude 3.5 Sonnet, GPT-4o ou Codex.
O resultado dessa abordagem ingênua é duplo e doloroso: latência desnecessária de 2 a 5 segundos por requisição e faturas exorbitantes de tokens no fim do mês que destroem a margem de lucro da operação.
A Ilusão do Modelo Único
O Ponto Técnico Crucial: O Que o JEV Realmente Faz
Existe uma confusão conceitual muito frequente sobre ferramentas de otimização de IA. Vamos alinhar a realidade técnica com clareza:
O Jev NÃO compacta tokens magicamente de qualquer LLM. Isso não existe na física das redes neurais transformer.
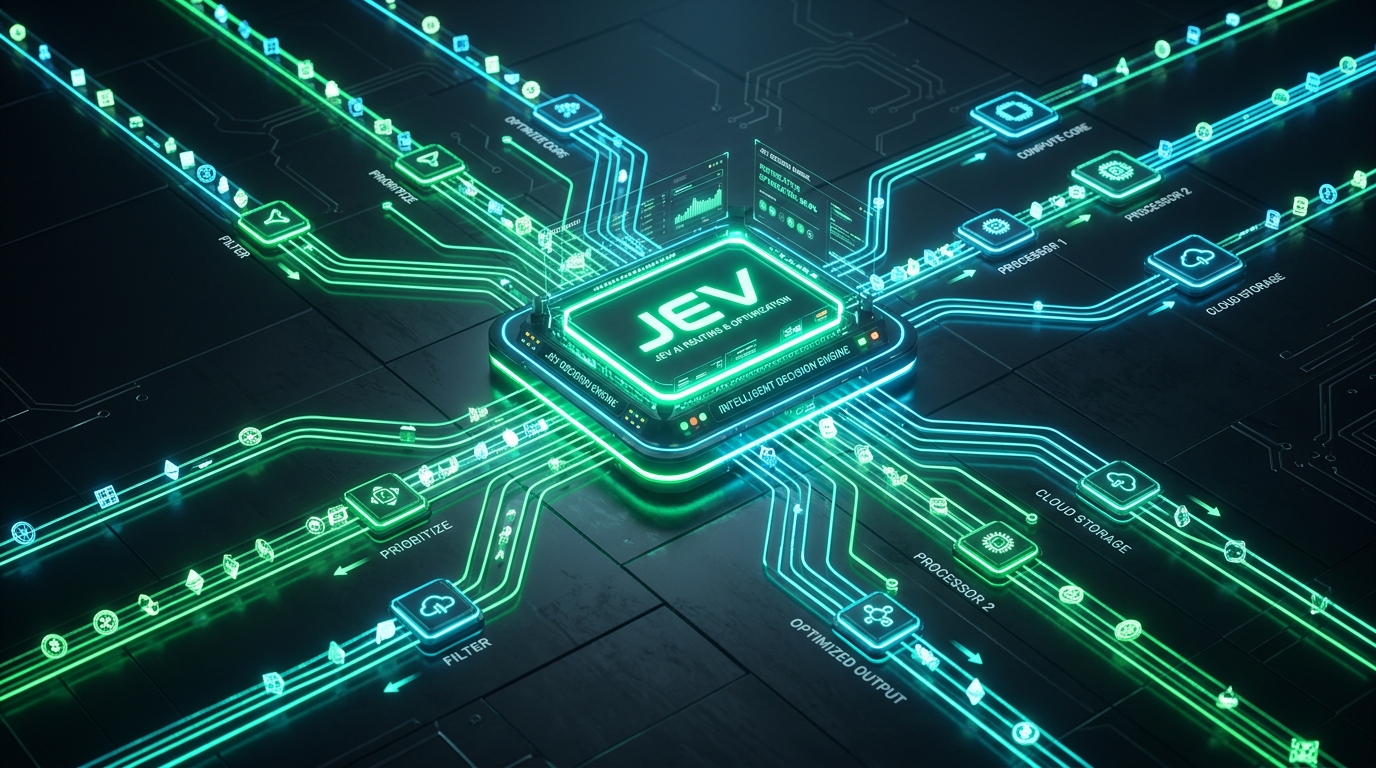
O Jev é um motor de decisões estruturadas rápidas e ultra baratas. A função primordial dele é atuar como uma central de triagem inteligente: classificar a intenção da entrada, escolher a rota ideal de execução e determinar se aquela solicitação realmente necessita de uma chamada de LLM ou se pode ser resolvida por uma regra determinística.
A economia real de tokens vem de evitar chamadas desnecessárias à LLM. O Jev resolve o que é rotineiro e barato na entrada, mantendo o Claude, o Codex ou qualquer outro modelo de ponta focado estritamente no trabalho de alto valor cognitivo: geração de texto refinado, síntese profunda e raciocínio aberto.
Tudo Vai Para a LLM
Cada interação bate diretamente no modelo mais caro. O custo escala de forma imprevisível, a latência aumenta e o risco de alucinações em tarefas simples prejudica o usuário.
Decisão Rápida Antes da Criação
O Jev avalia e encaminha a rota em milissegundos. Tarefas simples são resolvidas por fluxos diretos a custo quase zero; apenas casos complexos sobem para a LLM.
A Regra de Ouro
Os 4 Cenários Práticos de Produção com o JEV
Para entender como essa separação funciona no mundo real, veja quatro cenários onde o Jev gera economia drástica de tokens e aumento de velocidade:
Passo a Passo: Como Implementar o JEV na Prática
Para colocar essa arquitetura de economia em produção no seu produto ou agente hoje mesmo:
Mapeamento de Intenções (O Peneirão Inicial)
Liste as 20 solicitações mais frequentes dos seus usuários. Separe o que é determinístico (dados fixos, consultas ao banco, checagem de status) do que é genuinamente criativo e analítico.
Configuração do JEV na Camada de Entrada
Posicione o Jev como um roteador de borda logo no recebimento da mensagem. Ele avalia o payload em menos de 50ms e devolve uma classificação padronizada de rota.
Execução de Resposta Direta (Zero Tokens)
Rotas de rotina são resolvidas imediatamente por queries diretas no banco de dados (Supabase/PostgreSQL) ou automações no n8n sem tocar em nenhuma API de IA generativa.
Encaminhamento Seletivo para a LLM
Apenas quando o JEV identifica uma consulta complexa, ambígua ou que exige raciocínio generativo, o prompt refinado é enviado para o Claude 3.7 Sonnet ou Codex.
Economia Imediata no Bolso
Prompt Pronto: Desenhe o Roteador de Decisões do seu SaaS
Você não precisa criar uma infraestrutura complexa do zero para começar a aplicar a lógica do Jev no seu projeto. Use o prompt abaixo para que a sua IA desenhe a árvore de triagem estruturada:
Atue como meu Arquiteto de IA Sênior. Quero implementar uma camada de decisão estruturada e barata (inspirada no conceito do Jev) antes de chamar minhas LLMs caras (Claude 3.7 Sonnet / Codex / GPT-4o). Meu sistema é [descreva resumidamente o que seu SaaS ou agente faz]. 1. Mapeie todas as intenções e tipos de dados que meus usuários enviam no dia a dia. 2. Separe essas intenções em duas categorias nítidas: Categoria A (Tarefas Determinísticas de Rotina: que podem ser resolvidas por regras, banco de dados ou endpoints simples com zero tokens de LLM) e Categoria B (Tarefas de Alta Complexidade Cognitiva: que realmente exigem a geração e raciocínio de uma LLM). 3. Escreva um schema JSON de roteamento que classifique a mensagem na entrada em menos de 100ms e direcione a execução para a rota mais barata. 4. Estime a redução percentual de custo de tokens após essa blindagem.
Ao rodar esse prompt, você terá uma visão exata de quais chamadas de IA você pode cortar hoje mesmo sem perder um único milímetro de qualidade.
Da Otimização de Tokens ao SaaS Lucrativo
Cortar custos desnecessários com tokens não é apenas um detalhe técnico de economia: é o divisor de águas entre um projeto que dá prejuízo e um SaaS escalável com mais de 80% de margem líquida.
Acelere com a Mentoria
Gostou deste artigo? Compartilhe com sua rede!
Ajude outros desenvolvedores e empreendedores a dominarem IA e automações.
Grupo IA Pro no WhatsApp
Acompanhe em primeira mão novas ferramentas, prompts testados, servidores MCP, automações e bastidores de IA aplicada diretamente com o Fernando Bolzan e outros builders.
Destrave seu SaaS ou Projeto com IA
Direção técnica individual para sair do quase pronto: orquestração de agentes, n8n, Supabase, infra self-hosted barata e estratégia até venda e recorrência.